
编辑:前沿在线 编辑部
11月5日至10日,第九届中国国际进口博览会在上海举办。
开展以来,国家展中国馆的人流络绎不绝。
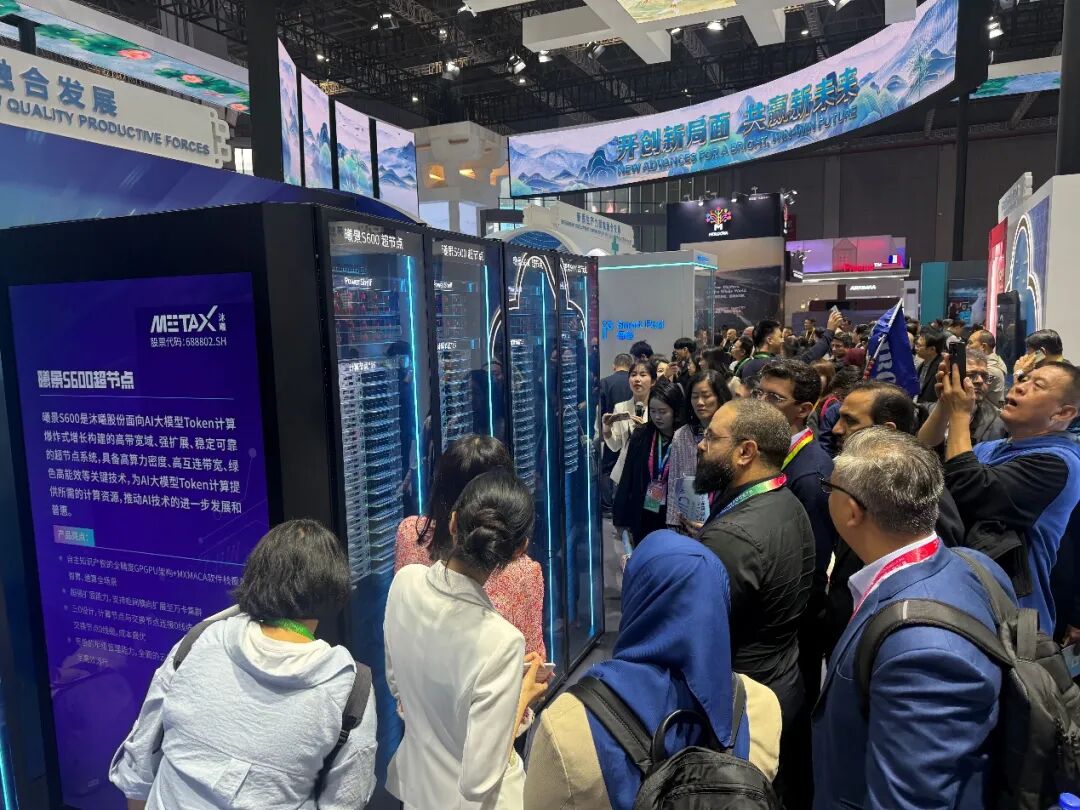
走到沐曦股份展台前,节奏会慢下来:有人把手机贴在机柜侧板上找线缆,有人蹲下去拍底座,还有人举着手机录那一排指示灯。
作为本届中国馆唯一入选的国产GPU企业,沐曦股份带来的两台“大件”——曦景S600超节点与“沐曦股份X东方算芯”异构双擎算力机柜,成了馆内最集中的“打卡点”之一。
国产超节点“火了”
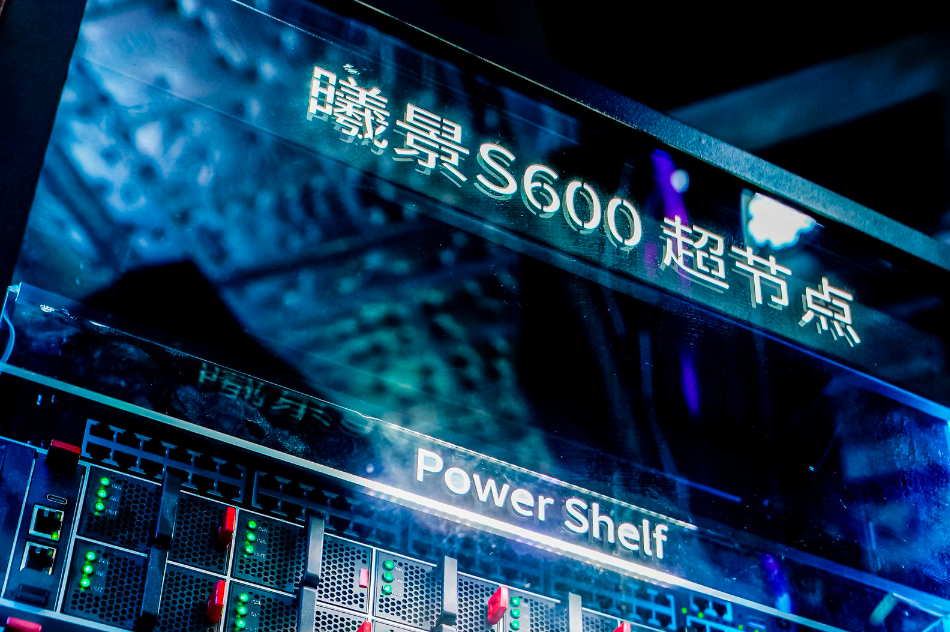
最先被围住的是沐曦曦景S600超节点。
这台面向大模型训练与推理、智算中心建设的系统级产品,把机房里的计算、交换、互联收进一个整机柜:一台机柜装128张卡,还是全交换、无带宽收敛的连法,往上能接到万卡集群,搭载的是沐曦曦云C600全国产旗舰GPU。
“为什么一根线都看不到”,是现场最高频的疑问。
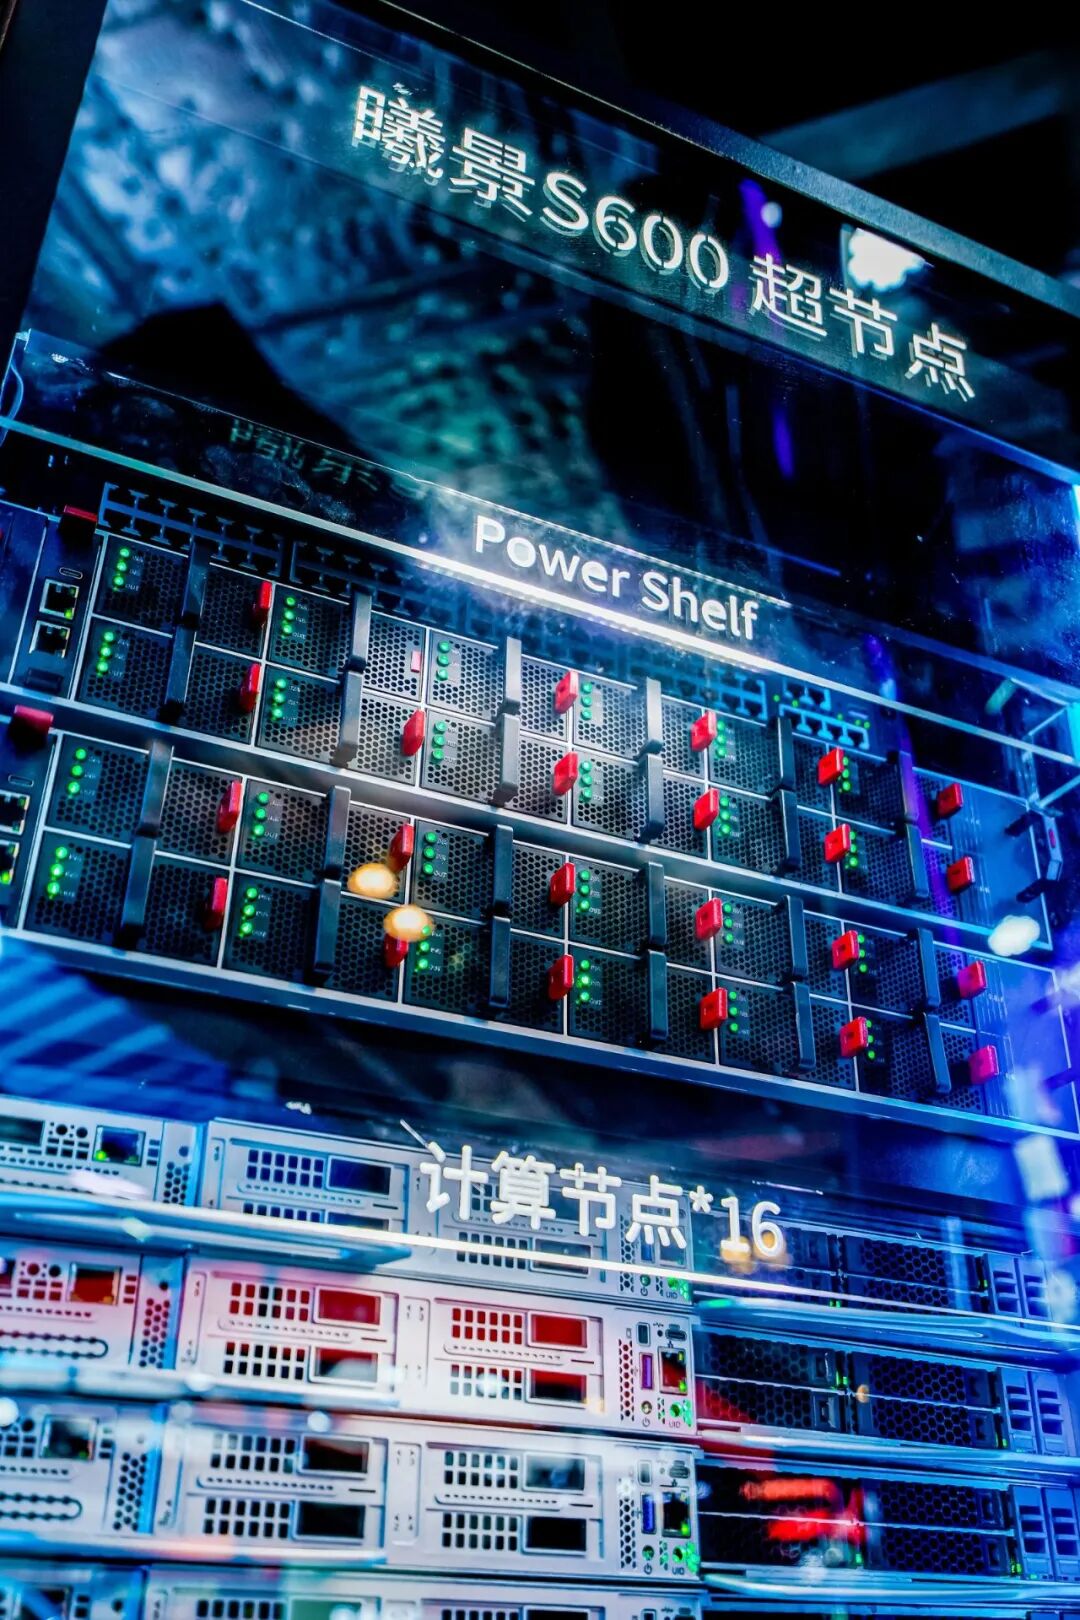
答案在“三0”——计算节点0线缆、交换节点0线缆、计算与交换节点间0线缆。
高密正交整机柜把布线、调试这些最依赖人工的活,提前在工厂里做完;配合解耦模块化架构,机房无需改造就能部署。
另一项异构算力机柜也吸引了不少人驻足围观。
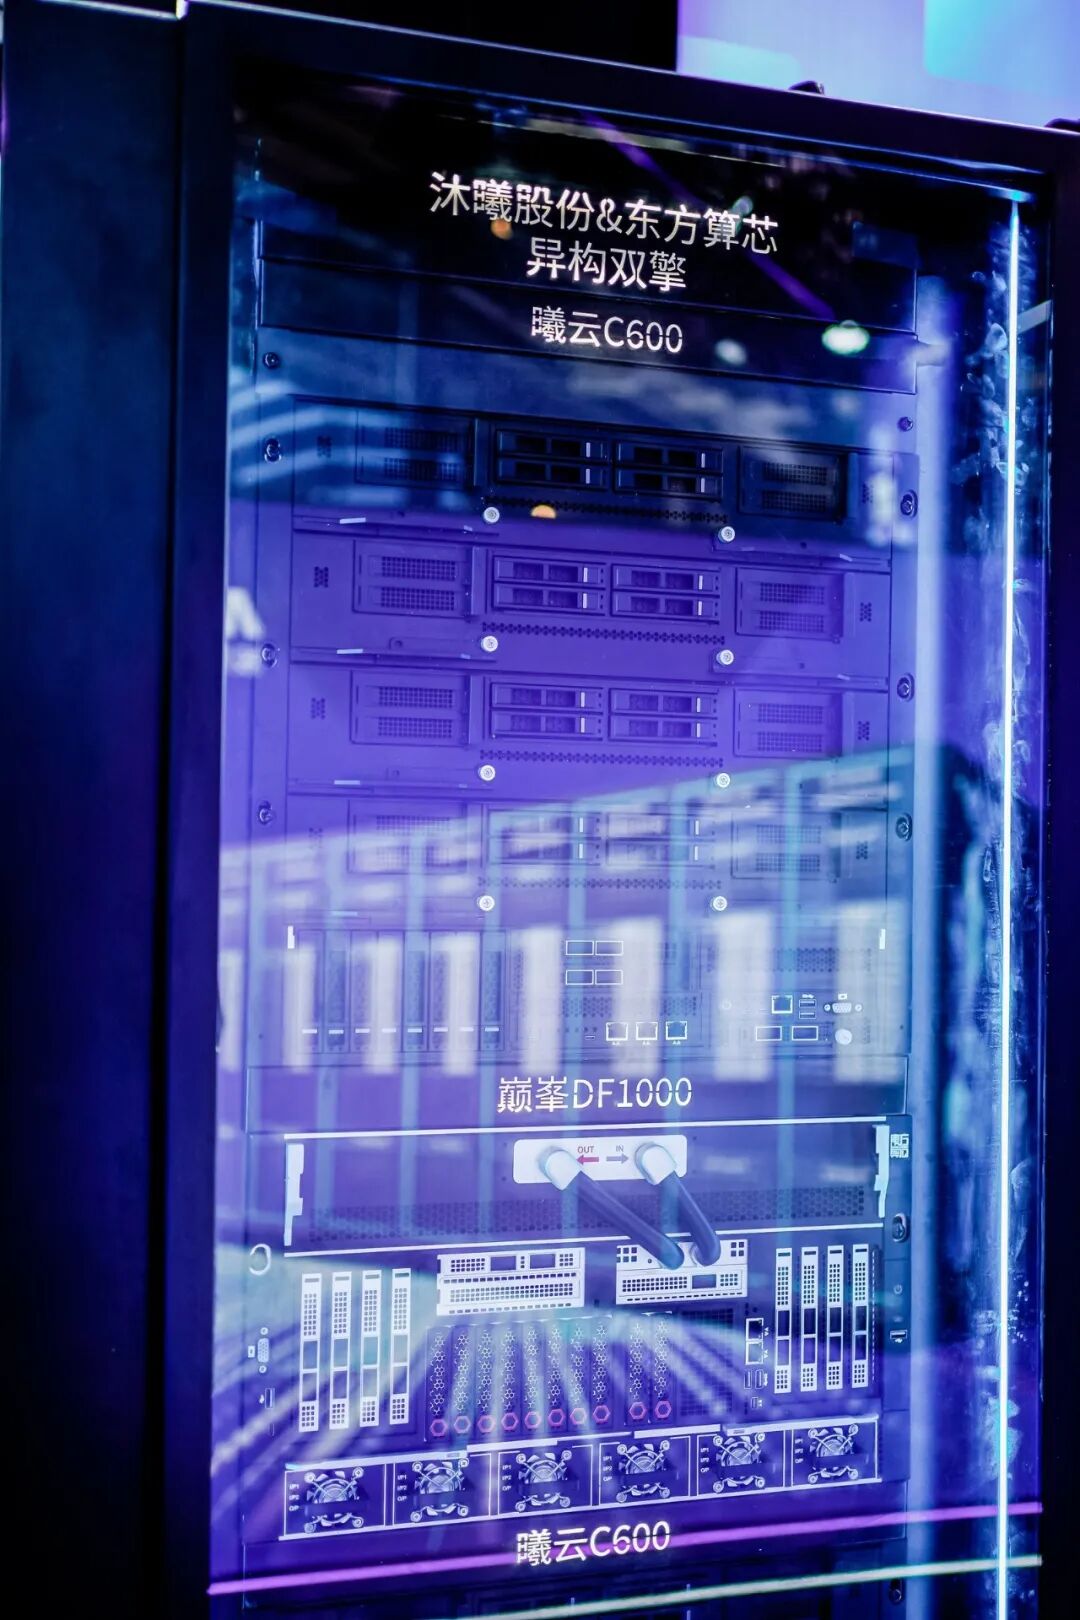
沐曦股份X东方算芯”异构双擎算力机柜,是沐曦股份与东方算芯联手打造:面向云端推理,把曦云C600与DF1000两颗不同架构的芯片装进同一套系统。
面向混合专家架构(MoE)模型推理时,注意力与专家网络在物理上解耦——C600做上下文关联等计算密集型任务,DF1000做稀疏激活等访存密集型任务,是“双芯分治”;投机解码时,DF1000低延迟流式生成草稿候选、C600批量精审校验,是“双芯合璧”。
镜头之外,他们在问什么
围拍的镜头里,海外面孔不少。
多位海外参展商在机柜前停留的时间明显更长:他们很少拍外观,更愿意绕到背板后面,盯着互联拓扑问:128卡怎么做到无带宽收敛?万卡集群怎么调度?软件栈能不能迁到现有平台?
后两个问题,指向MXMACA软件栈平台与MetaXLink高速互联技术。
被追问最多的一句是“为什么要用两种芯片”。
答案不在芯片本身:推理的瓶颈早就不在单点算力,而在“访存墙”与“计算墙”之间来回摇摆——一种芯片很难同时把两件事都做便宜。
国产算力“被看见”
过去,算力离普通人很远,它曾是机房深处的轰鸣,是规格表上一串串冰冷抽象的算力参数。
而如今,它们以整机柜的姿态稳稳站在进博会国家展的展台中央,变得看得见细节、量得出尺度、扛得住现场追问。
中国馆里那些被长镜头与聚光灯频频围住的瞬间,不仅折射出观众对大模型底座的强烈好奇,更是国产算力脱离“参数叙事”、真正扎进“产业现场”的一个生动切面。
从“能被看见”到“真正在干”,国产算力正在进行一场深刻蜕变——告别单打独斗的纸面峰值比拼,全面走向软硬一体、系统协同与产业实干的新阶段。
作为本届中国馆唯一入选的国产GPU企业,沐曦股份在此展示的不只是产品,更是中国GPU产业在面对大模型商业化落地浪潮时,脚踏实地踩出的底气与阵脚。
END –

